Cuộc thi AI Việt Nam - Nhật Bản 2026 · Vòng chung kết · 07/11/2026
KaimeiNơi nhà khoa học cùng các tác nhân AI đẩy nhanh* hành trình khám phá thuốc.
Đội OSK LAB
* Nhanh hơn Claude Science2,4~38lần trên cùng đề bài.

Cuộc thi AI Việt Nam - Nhật Bản 2026 · Vòng chung kết · 07/11/2026
KaimeiNơi nhà khoa học cùng các tác nhân AI đẩy nhanh* hành trình khám phá thuốc.
Đội OSK LAB
* Nhanh hơn Claude Science2,4~38lần trên cùng đề bài.
Em chào ban giám khảo và các anh chị. Em là Nghĩa, đại diện đội OSK LAB. Hôm nay, đội em đến với cuộc thi xin giới thiệu giải pháp mang tên Kaimei. Kaimei xây dựng các tác nhân AI cho khoa học sự sống, nhằm đẩy nhanh khám phá thuốc cùng các nhà khoa học y sinh.
Vì sao đội em chọn chủ đề khám phá thuốc? Vì cuộc đời mỗi người, từ khi sinh ra đến lúc về già, ai trong chúng ta cũng cần tới thuốc và vắc xin, đó là một nhu cầu thiết yếu không thể tách rời cuộc sống. Năm 2020, đại dịch COVID-19 bùng phát và ảnh hưởng tới mọi mặt đời sống, từ sức khỏe, công việc tới kinh tế. Chính trải nghiệm ấy là động lực để đội em nghiên cứu các giải pháp cho thuốc và y tế. Kaimei tập trung vào công nghệ sinh học trong khám phá thuốc, dành cho các nhóm nghiên cứu thuốc tại doanh nghiệp và trường đại học.
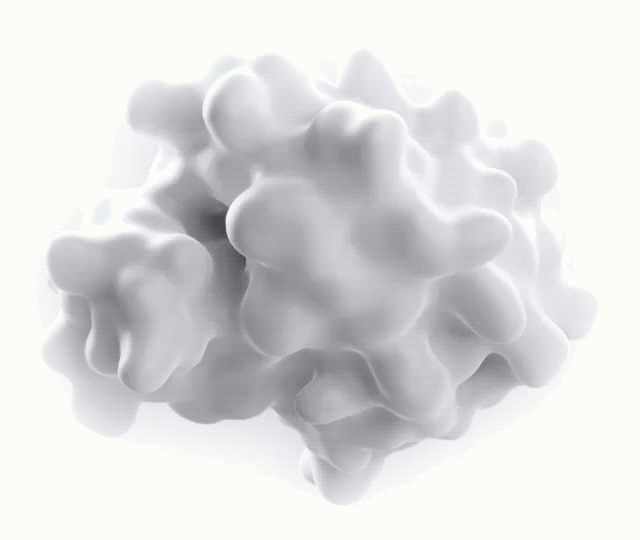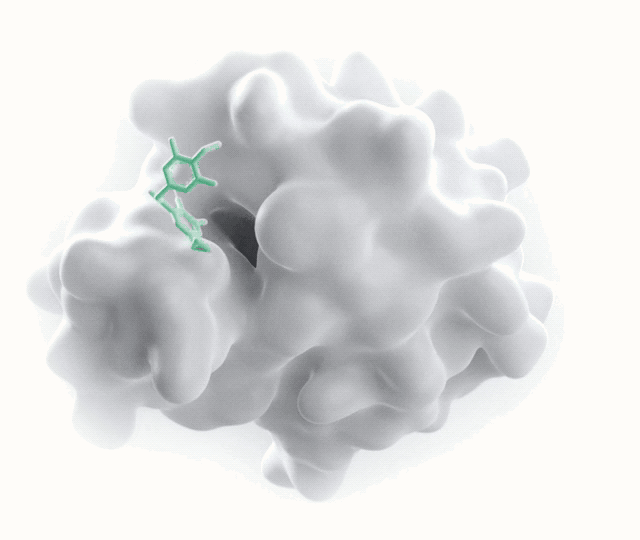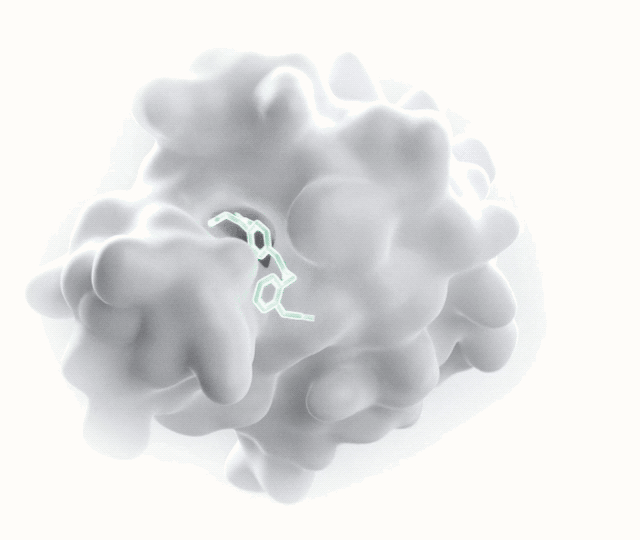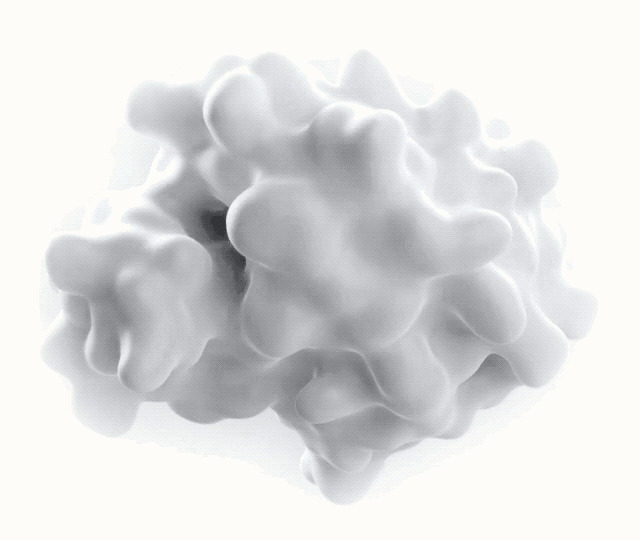
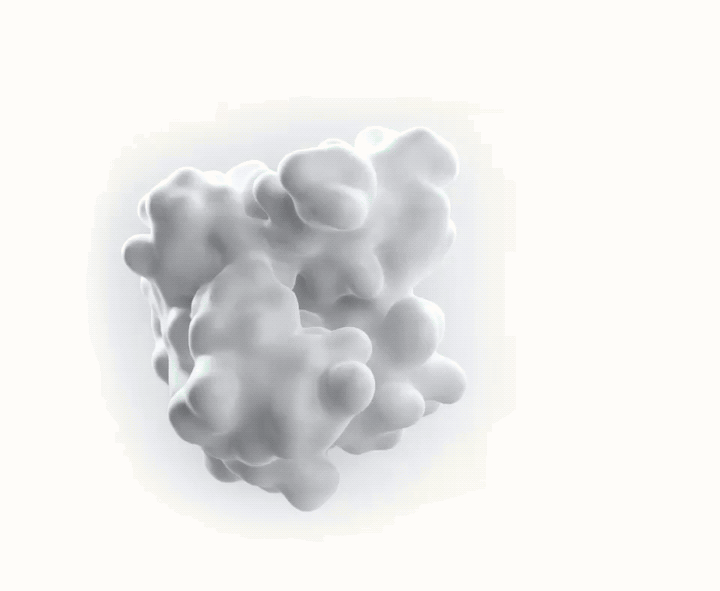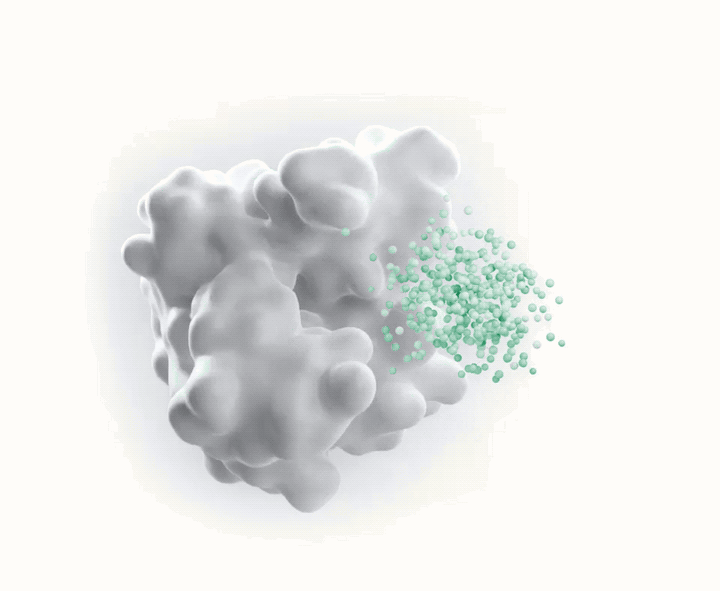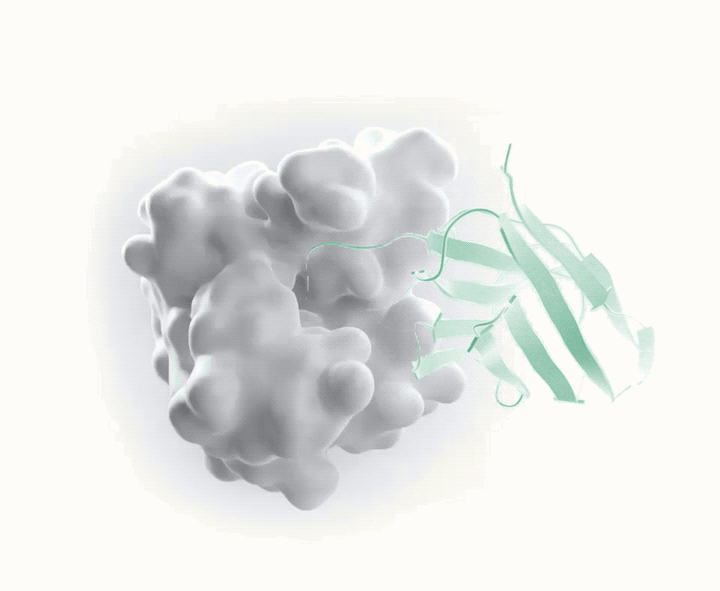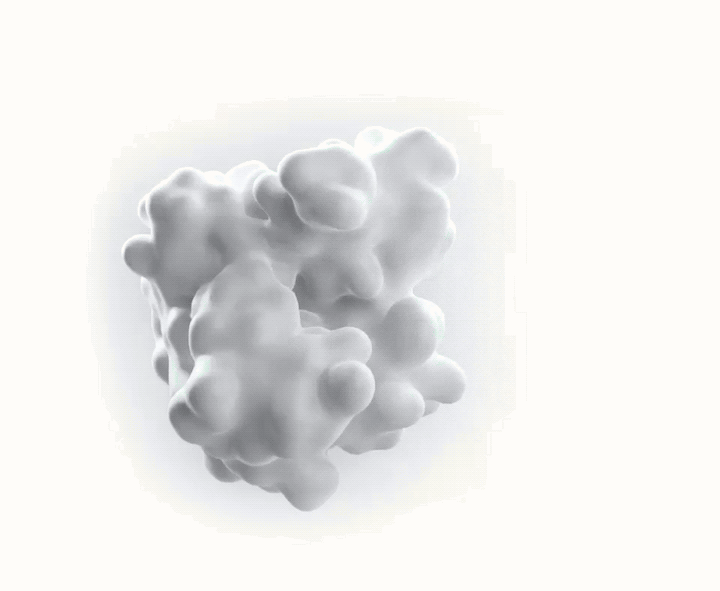
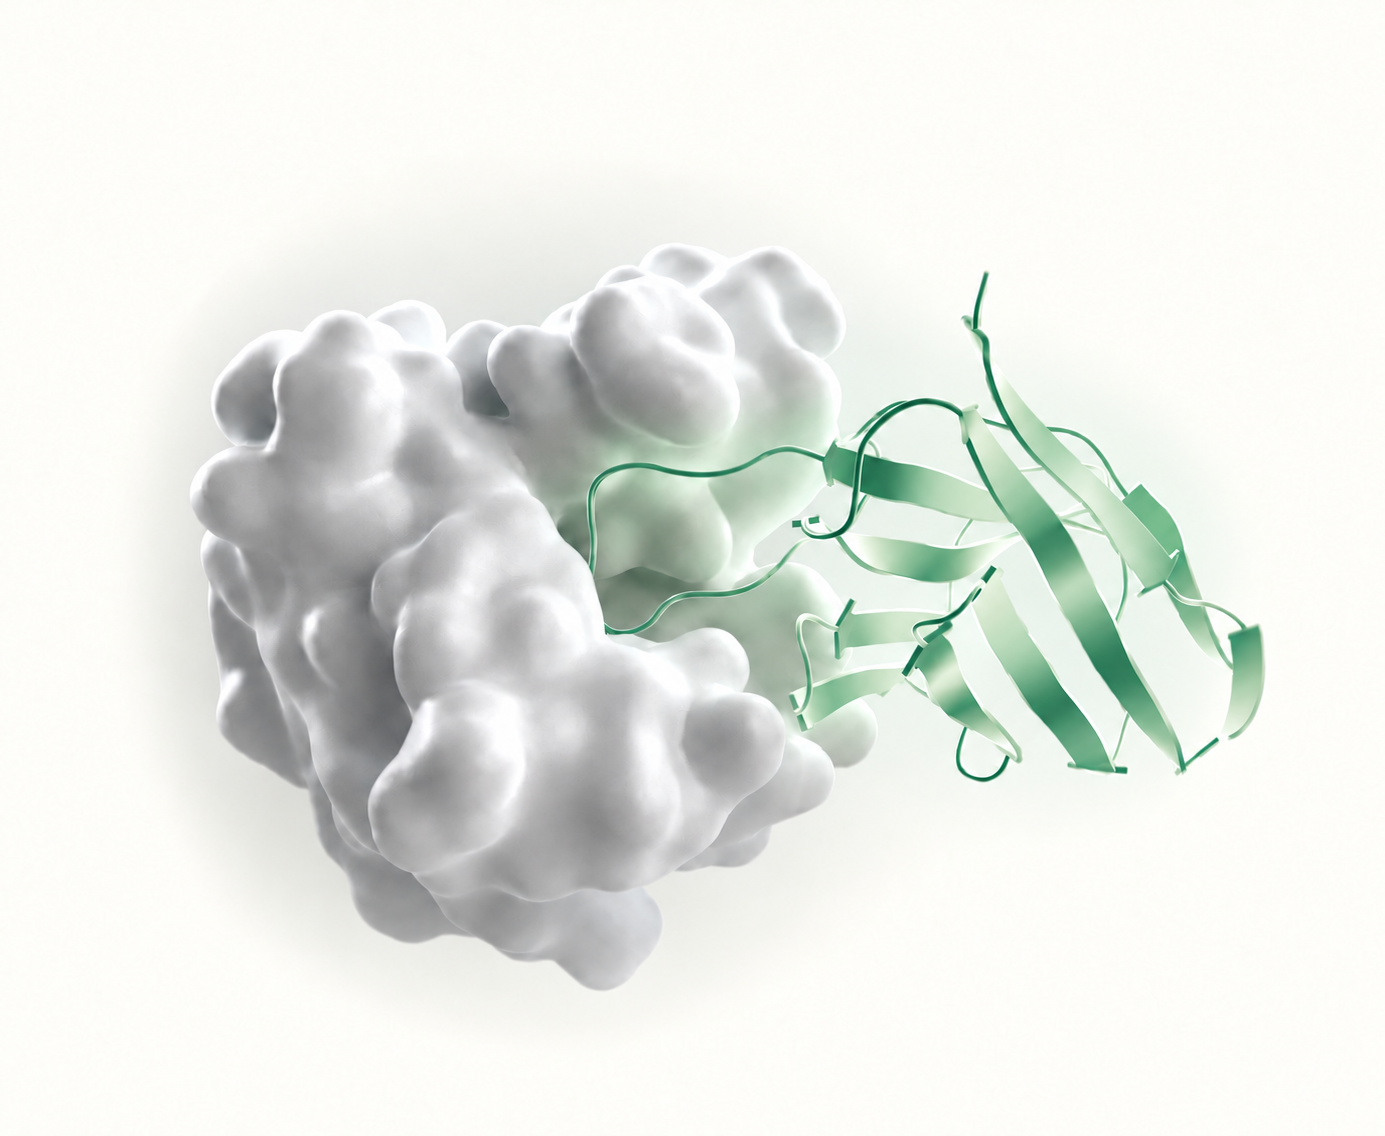
Tên dự án và một câu định vị, nói ngay sau lời giới thiệu của MC. Hình là một binder đã gắn vào protein đích.

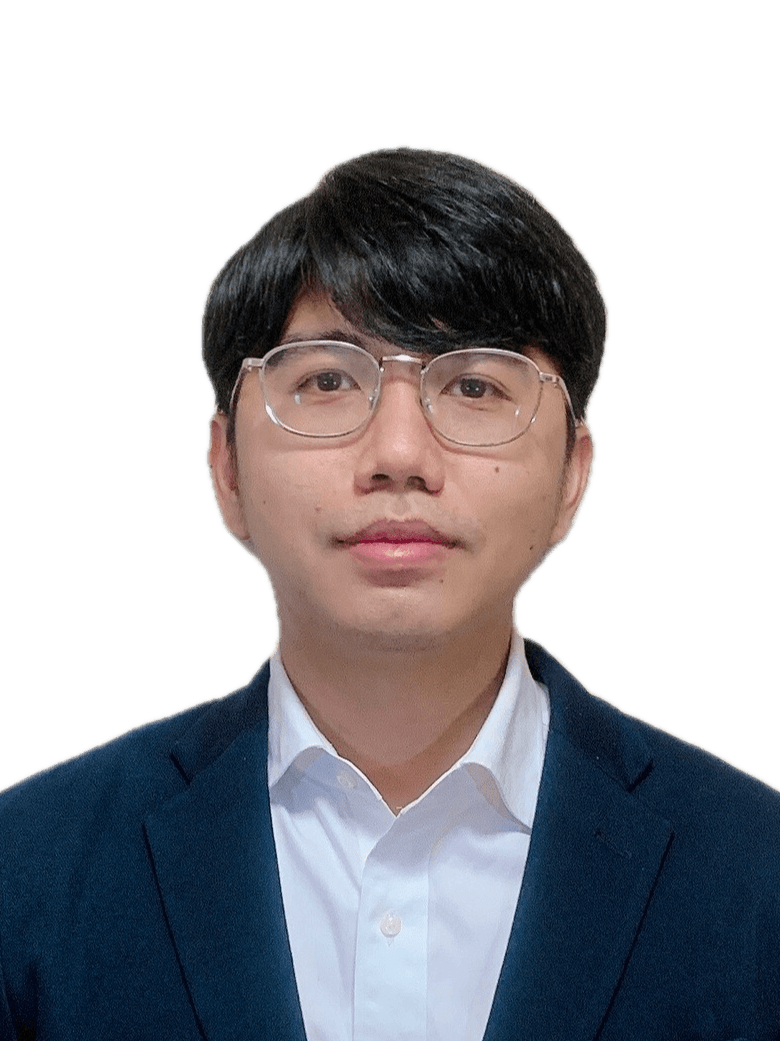
Leader
Product Owner · Software Engineer

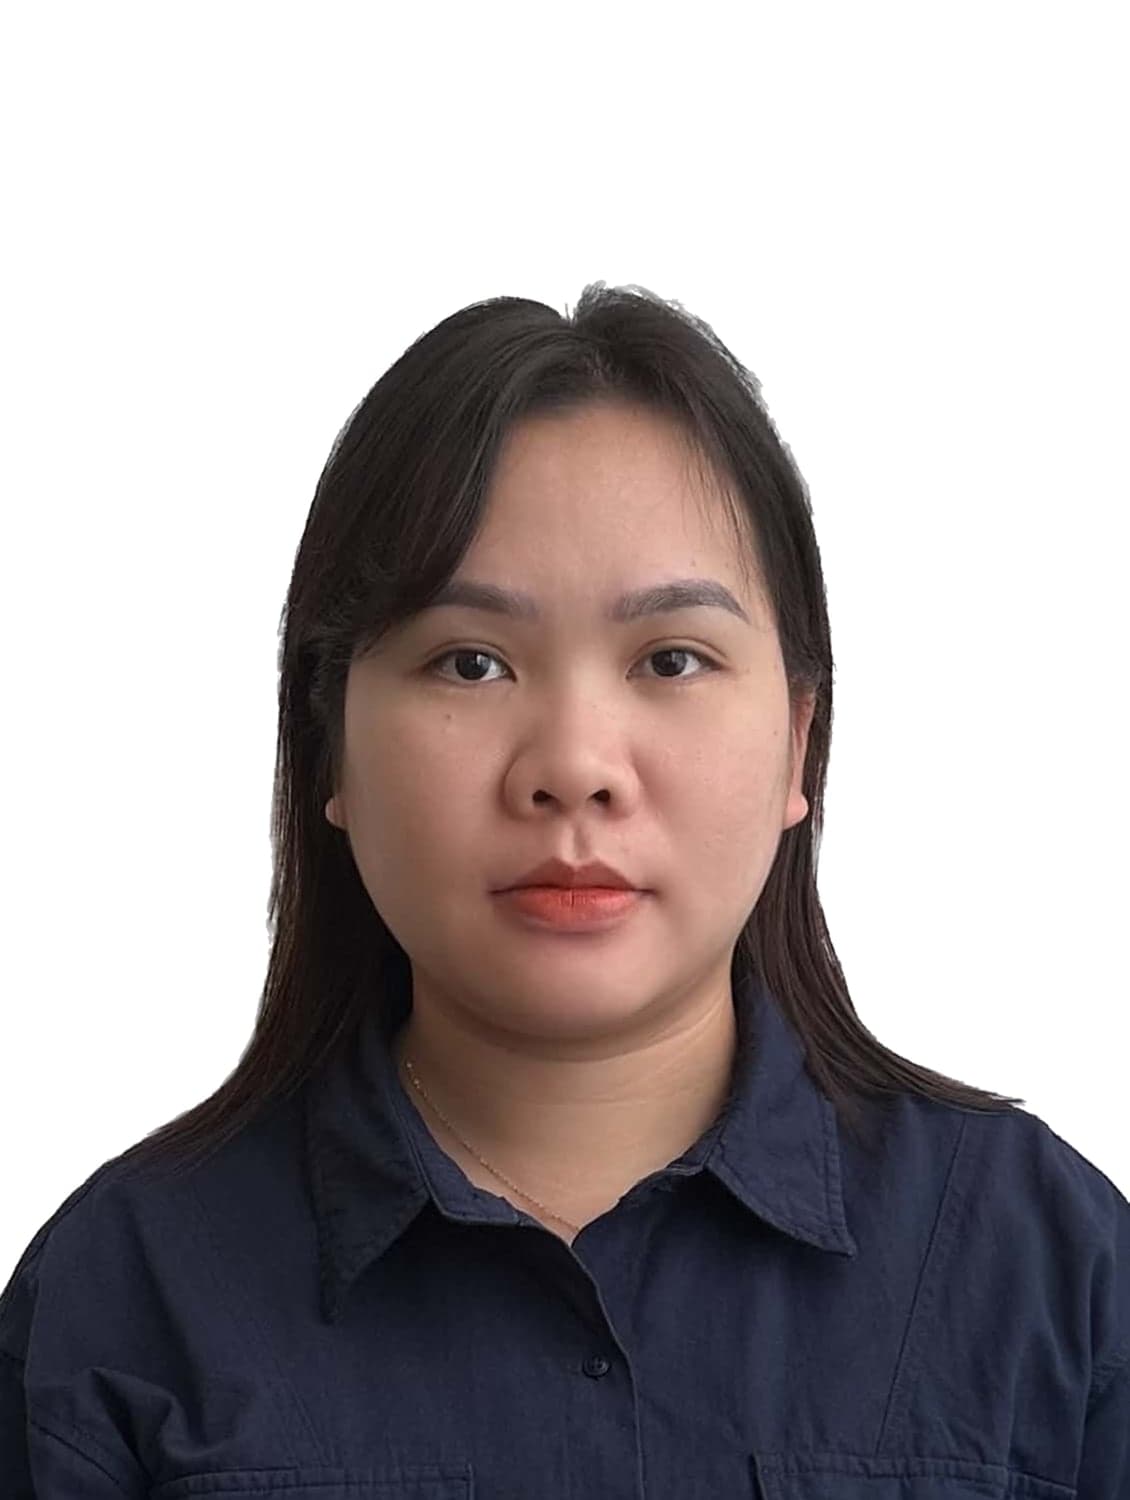
Member
Business Analyst · Tester
Đội ngũ đứng sau Kaimei, kết hợp kinh nghiệm sản phẩm, phần mềm y tế và nghiệp vụ bệnh viện.
Với nhiều năm kinh nghiệm làm việc trong cùng lĩnh vực, đội hiểu rõ pain point và đề xuất xây dựng giải pháp sát nhu cầu thực tế.
Em là Nghĩa, leader của OSK LAB, phụ trách sản phẩm và kỹ thuật của Kaimei. Em có hơn năm năm phát triển phần mềm y tế và khoa học đời sống. Với vai trò PO, em xây dựng các giải pháp y tế phục vụ hoạt động presales của bộ phận và công ty, đồng thời tham gia nhiều triển lãm trong lĩnh vực y tế và dược phẩm. Đồng hành với em là Huệ, có gần bốn năm làm việc tại 第二協立病院 và kinh nghiệm nghiệp vụ y tế trong môi trường bệnh viện. Huệ phụ trách phân tích yêu cầu, kiểm thử và nghiệm thu sản phẩm. Với nhiều năm kinh nghiệm làm việc trong cùng lĩnh vực, đội em hiểu rõ pain point và đề xuất xây dựng giải pháp sát nhu cầu thực tế.
Giới thiệu đội trước nội dung trình bày với hai cột cân đối: Nghĩa mang kinh nghiệm sản phẩm, kỹ thuật và tiếp xúc thị trường; Huệ mang gần bốn năm làm việc trong bệnh viện và kinh nghiệm nghiệp vụ y tế.
01
Kiến Thức Ngành & Thuật Ngữ
Domain Knowledge & Glossary
Thuốc gắn vào đích thế nào, và các thuật ngữ sẽ dùng trong bài.
02
Vấn Đề
Problem
Vì sao 90% ứng viên thuốc thất bại, và điều gì khiến bốn giai đoạn đầu nhiều thách thức.
03
Giải Pháp & Agentic AI
Solution & Agentic AI
Kaimei đi từ câu hỏi nghiên cứu tới báo cáo có nguồn thế nào, và đội agent làm việc phía sau.
04
AI Có Trách Nhiệm
Responsible AI
Tám rủi ro, mỗi rủi ro có rào chắn riêng, để lab yên tâm giao dữ liệu cho agent.
05
MVP & Tính Khả Thi
MVP & Feasibility
Bản MVP đang chạy và giá trị mang lại cho từng nhóm.
06
So Sánh Các Nền Tảng
Platform Comparison
Kaimei trong bức tranh chung, và số đo thực tế khi chạy cùng đề bài với Claude Science.
07
Kế Hoạch Phát Triển
Development Plan
Lộ trình theo quý năm 2027 và giai đoạn Q1-Q4 2028, với mốc Pharma IT Expo tháng 4/2027.
Bài trình bày gồm sáu phần: kiến thức ngành và thuật ngữ, vấn đề, giải pháp, AI có trách nhiệm, MVP và tính khả thi, cuối cùng là kế hoạch phát triển.
Cho giám khảo bản đồ của năm phút: sáu phần đánh số trên một trục thời gian, theo nội dung BTC gợi ý, và mỗi slide sau mang đúng số đó để theo dõi.
Ổ khóa và chìa khóa
Đích và thuốc
Phân Tử thay đổi tư thế để gắn khớp vào Đích ở vị trí Túi Gắn
Ổ khóaĐích (Target)
Protein mà bệnh đi qua, ở đây là EGFR.
Lỗ khóaTúi gắn (Pocket)
Rãnh trên đích, nơi phân tử gắn vào.
Chìa khóaPhối tử (Ligand)
Phân tử khớp vào túi, được tối ưu để thành thuốc: erlotinib.
Phân tử nhỏ
(Small molecule)
dưới 900 Da
Ví dụ: paracetamol, aspirin
Phân tử trung bình
(Middle molecule)
500-2.000 Da
Ví dụ: cyclosporin, vancomycin
Sinh học
(Biologic)
thường trên 10.000 Da
Ví dụ: kháng thể trastuzumab, adalimumab

Một bệnh thường đi qua một protein gọi là đích (Target), trên đích có một túi gắn (Pocket) nhỏ nơi protein làm việc. Thuốc là phân tử vừa khít túi đó như chìa vừa ổ khóa, khi nằm trong túi thì protein bị ức chế, không còn truyền tín hiệu để tế bào bệnh phát triển.
Khám phá thuốc là tìm một phân tử vừa khít túi (Pocket) của đúng đích (Target), rồi chứng minh phân tử đó đủ an toàn để chữa bệnh.
Trước khi đi vào vấn đề, em xin chia sẻ một chút kiến thức chuyên ngành, để anh chị ngoài ngành dễ theo dõi. Phần lớn bệnh đều đi qua một protein trong cơ thể, gọi là đích. Anh chị hãy hình dung protein đích như một ổ khóa. Trên bề mặt protein có một túi gắn nhỏ, đó là lỗ khóa. Còn phân tử thuốc chính là chiếc chìa khóa vừa khít với lỗ khóa ấy. Khi chìa khóa nằm gọn trong túi, protein bị ức chế, không làm bệnh phát triển thêm được nữa.
Chìa khóa có nhiều cỡ. Có phân tử nhỏ như paracetamol hay aspirin mà mình vẫn uống hằng ngày, có phân tử trung bình, và có thuốc sinh học lớn như kháng thể. Đoạn hình bên phải là cảnh một phân tử xoay, đổi tư thế rồi khớp vào túi gắn của đích. Nói đơn giản, khám phá thuốc là đi tìm chiếc chìa vừa khít đúng ổ khóa, rồi chứng minh chiếc chìa đó đủ an toàn để chữa bệnh.
Cho giám khảo ngoài ngành sinh học đủ nền để theo các slide sau: hình ổ khóa và chìa khóa của Appendix A, ba loại thuốc theo kích thước, và bảng thuật ngữ chỉ gồm những từ có trong bài nói và trên slide.
Sinh học và thuốc
EGFR
Protein đích của ca demo, đột biến ở EGFR gây một số ung thư phổi.
Erlotinib, 1M17
Thuốc đã duyệt nhắm EGFR, và cấu trúc 3D của cặp đó trong RCSB PDB.
Hit, lead
Hit là phân tử có hoạt tính trên đích, lead là hit đáng đem đi tối ưu.
Docking
Đặt phân tử vào túi của đích để đoán tư thế gắn và độ khít.
Protein structure, fold
Hình 3D của protein, fold là dự đoán hình đó bằng model AI.
Å
Ångström, một phần mười nanomet, đo độ lệch giữa các nguyên tử.
ADMET
Thuốc được hấp thu, phân bố, chuyển hóa, thải trừ ra sao, có độc không.
Preclinical, Phase I/II/III
Thử trên tế bào, động vật, rồi ba pha trên người trước khi duyệt.
Kaimei và AI
Agent, sub-agent
Agent điều phối lập plan, giao từng phần cho agent con chuyên một mảng.
Skill
Gói hướng dẫn và code cho một việc chuyên môn, agent gọi khi cần.
Node, pipeline, canvas
Mỗi bước là một node, các node nối thành pipeline trên canvas.
Sandbox
Môi trường kín chạy code của agent, không mạng tự do, không thấy key.
HITL
Human-in-the-loop: người duyệt plan trước khi chạy và duyệt báo cáo cuối.
Tenant
Không gian riêng của một lab, dữ liệu không lẫn với lab khác.
Benchmark
Cùng một bài chạy trên nhiều hệ thống, chấm theo tiêu chí chốt trước để so sánh công bằng.
ChEMBL, UniProt, RCSB PDB
Cơ sở dữ liệu công khai về hoạt tính phân tử, protein và cấu trúc 3D.
Còn đây là những thuật ngữ đội em sẽ dùng trong bài, mỗi từ kèm một câu giải thích ngắn.
Để sẵn trên màn hình cho giám khảo ngoài ngành đọc, không đọc từng từ.
Drug Discovery Stage
Challenge
CandidatesTarget Validation
1.5 yrs · 3% cost
Bằng chứng liên quan nằm rải rác qua hàng trăm bài báo và cơ sở dữ liệu.
Compound Screening
1.5 yrs · 6% cost
Sàng lọc thủ công thư viện lớn mất nhiều tuần, kèm nhiều công sức dựng hạ tầng tính toán.
Lead Optimization
1.5 yrs · 17% cost
Mỗi công cụ cần pipeline và chuyên gia riêng, còn vòng lặp tối ưu analog làm chậm con đường từ hit tới ứng viên thuốc.
Preclinical
1 yr · 7% cost
Rủi ro an toàn được phát hiện sau khi tổng hợp khiến lab phí nhiều tháng làm việc.
Phase I/II/III to Approval
8 yrs · 67% cost
Đích yếu hay phân tử không an toàn thường thất bại ở giai đoạn này, sau nhiều năm và phần lớn ngân sách.
Source: Sun D. et al., Acta Pharm Sin B, 2022
Từ hơn 10.000 hợp chất tiềm năng chỉ lọc còn một thuốc được phê duyệt. Bốn giai đoạn đầu tốn 33% chi phí nhưng quyết định phân tử nào vào giai đoạn lâm sàng.
Kaimei tập trung hỗ trợ đẩy nhanh quá trình khám phá thuốc từ giả thuyết đến kiểm chứng có căn cứ ngay từ đầu, để giảm bớt thất bại ở giai đoạn tiếp theo và mang thuốc an toàn đến cho bệnh nhân.
Nghe thì đơn giản, nhưng thực tế lại rất khó. Để đưa một thuốc mới ra thị trường, các nhóm nghiên cứu bắt đầu từ việc tìm và thẩm định đích, rồi sàng lọc hơn mười nghìn hợp chất, tối ưu những phân tử tốt nhất, thử ở tiền lâm sàng và qua ba pha thử trên người. Cuối cùng chỉ còn một thuốc được phê duyệt và đưa ra thị trường. Cả hành trình đó mất từ mười đến mười lăm năm, tốn hơn một tỷ đô la. Vậy mà chín trên mười ứng viên vẫn thất bại khi đã thử trên người, phần lớn vì không đủ hiệu quả hoặc vì độc tính.
Điều đáng nói là thất bại lộ ra rất muộn, nhưng lại được quyết định từ rất sớm. Bốn giai đoạn đầu, trước khi thử trên người, chỉ chiếm khoảng một phần ba chi phí, nhưng lại là lúc nhà khoa học chọn đích và chọn hợp chất nào được đi tiếp. Chọn đúng từ đầu thì cả hành trình phía sau bớt được rất nhiều thất bại. Đó là chỗ đội em muốn giúp.
Phễu dòng chảy dọc giữa slide: ba con số ở góc, dải ứng viên thu hẹp qua bốn giai đoạn trong phạm vi của đội rồi mờ dần qua lâm sàng, mỗi giai đoạn kèm khó khăn hôm nay, để quy mô vấn đề và chỗ Kaimei đứng hiện ra trong vài giây.
Scientist
Approve Plan
Propose Plan
UniProt FASTA
ChEMBL TSV
PubChem JSON
Docking SDF
Script Python
Excel by hand
AI Agent
Data leaked
Planted instruction
Invented value
No record of why
Một mục tiêu công việc,
cần nhiều công cụ,
mỗi công cụ một định dạng
Dữ liệu cần xử lý thủ công lớn,
model hóa sinh nặng cần NVIDIA GPU
(H/B tier) và yêu cầu chuyên gia
tin sinh thực hiện
Agent được đưa vào Labs
để tăng tốc nhưng cũng
nhiều rủi ro tiềm ẩn
Dữ liệu khám phá thuốc là
tài sản trí tuệ của labs
Nhà khoa học cần một nền tảng hỗ trợ đa dạng công cụ, cùng kết hợp với Agent đủ tin cậy để lab yên tâm giao dữ liệu.
Vậy ở bốn giai đoạn đó, nhà khoa học đang làm việc thế nào? Anh chị thử hình dung một buổi sáng của họ: mở UniProt tra thông tin protein, sang ChEMBL lấy dữ liệu hoạt chất, chạy phần mềm docking, viết thêm vài đoạn script, rồi chép từng con số vào Excel. Mỗi công cụ một định dạng, nên chưa tới trưa họ đã mệt vì ghép dữ liệu bằng tay. Những model nặng như dự đoán cấu trúc còn cần máy GPU cấu hình lớn, thứ mà nhiều lab nhỏ không có.
Gần đây, nhiều lab bắt đầu giao việc cho agent AI để tăng tốc. Nhưng một agent có quyền vào dữ liệu của lab cũng mang theo rủi ro: có thể làm lộ dữ liệu, làm theo một lệnh cài sẵn trong tài liệu, bịa ra số liệu, hay chạy xong mà không để lại lý do vì sao. Hai khó khăn này, công cụ rời rạc và rủi ro khi dùng agent, chính là điều Kaimei ra đời để giải quyết.
Phần 02 kể một câu chuyện liền mạch (chủ dự án, Oct 19, 2026): một buổi sáng qua sáu công cụ, rồi các lab giao việc cho agent và gặp bốn rủi ro mà Huynh và cộng sự (2026) nêu trong mục thách thức của agentic AI. Mỗi khó khăn được giải ở slide sau: Giải pháp gom công cụ, Agentic AI cho người duyệt từng plan, AI Có Trách Nhiệm chặn từng rủi ro.
06 · Canvas & Nodes
Mỗi bước thử nghiệm là một node nối với nhau, điều chỉnh, kết quả và các bước hỗ trợ rà soát.
Next.jsReactMol* Viewer
05 · Agentic AI
20+ skill chuyên ngành, mỗi báo cáo được kiểm lại với đầu ra công cụ.
LangGraphTemporal
04 · Context & Knowledge
Tri thức từ file và bài báo của user, bộ nhớ qua các phiên.
PostgreSQL 16Content-addressed files
03 · Biology & Small Molecule Tools
Hơn 15 model, tools dạng node: không cần cài đặt, không cần GPU riêng.
NVIDIA NIMBoltz-2DiffDockRDKit
02 · Data & Integrations
Dữ liệu công khai và file của lab, đọc tận nguồn và gộp sẵn.
UniProtRCSB PDBChEMBLPubChem
01 · Your Secure Environment
Mỗi tổ chức một tenant, agent và code xử lý trong sandbox.
Docker sandbox per sessionEgress proxy
Mỗi phiên chạy trong sandbox kín: agent có sẵn skill và công cụ sinh học trên Cloud GPU, mỗi bước thành một node trên canvas để dễ truy vết.
Giải pháp của đội em là gom tất cả những phần việc rời rạc đó vào một hệ thống. Anh chị có thể nhìn Kaimei như sáu lớp xếp chồng lên nhau. Dưới cùng là môi trường an toàn riêng cho từng lab. Bên trên là dữ liệu công khai và file của lab, rồi hơn mười lăm model sinh học chạy sẵn trên GPU, không cần cài đặt. Tiếp theo là ngữ cảnh, giúp agent hiểu đúng dự án của từng lab. Rồi tới agent với hơn hai mươi skill chuyên ngành. Và trên cùng là canvas, nơi mỗi bước hiện thành một node để nhà khoa học theo dõi.
Nhờ vậy, ba điều thay đổi. Thứ nhất, từ bài báo, dữ liệu, model tới kết quả đều nằm trong một phiên, các nhóm có thể chia sẻ và làm cùng nhau. Thứ hai, phân tích mà agent đã chạy được lưu thành một quy trình, dùng lại được cho dữ liệu và thử nghiệm khác. Thứ ba, mỗi phiên chạy trong sandbox riêng, mọi bước đều được ghi lại, và dữ liệu của lab chỉ đi tới mô hình bên ngoài khi lab cho phép.
Slide này là mục Solution & Innovation của proposal (chủ dự án, Oct 19, 2026): sáu lớp xếp chồng, mỗi lớp kèm công nghệ dựng nên lớp đó, lời dẫn nói kiến trúc phần mềm (Oct 20, 2026). Slide sau mới mở đội agent ra.
Nêu yêu cầu,
đặt ngân sách
Duyệt kế hoạch,
dừng bất cứ lúc nào
Nhà khoa học
Agent điều phối
KaimeiChia việc cho các
agent chạy song song
Agent tìm đích
Agent protein
Agent hóa học
Agent đọc tài liệu
20+ kỹ năng chuyên môn
15+ công cụ trên NVIDIA GPU
Cổng rà soát
Kiểm tra nguồn
Sàng lọc chất độc
Kiểm tra trước
khi báo cáo
Báo cáo & tệp
Nhà khoa học duyệt cuối
Khám phá thuốc ở giai đoạn đầu thường không có công thức cố định: mỗi câu hỏi cần nguồn, mô hình tính toán và các bước tiến hành riêng.
Vì sao lại cần agent, mà không chỉ là một chatbot hỏi đáp? Vì khám phá thuốc không có công thức cố định. Mỗi câu hỏi cần nguồn dữ liệu, mô hình và các bước riêng, và kết quả của bước trước thường làm thay đổi bước sau.
Hình này kể cách Kaimei làm việc. Bắt đầu từ nhà khoa học, đặt câu hỏi bằng lời và đặt ngân sách. Agent điều phối đọc ngữ cảnh, lập kế hoạch, và chỉ chạy khi nhà khoa học đã duyệt. Sau đó agent điều phối chia việc cho các agent chuyên môn chạy song song: agent tìm đích, agent protein, agent hóa học và agent đọc tài liệu, mỗi agent có skill riêng cho mảng của mình. Trong lúc các agent con làm việc, agent chính vẫn sẵn sàng nhận câu hỏi mới, nên nhà khoa học không phải chờ.
Kết quả không đi thẳng ra ngoài, mà phải qua cổng rà soát: kiểm nguồn của từng con số và sàng lọc chất độc. Cuối cùng là báo cáo và các file kết quả, và người ký duyệt sau cùng vẫn là nhà khoa học. Họ có thể bấm Stop bất cứ lúc nào.
Trả lời câu hỏi AI nằm ở đâu bằng ba vòng nối: vòng của người, vòng của các agent, vòng của cổng rà soát. Chỗ hai vòng chạm nhau là chỗ chuyển việc.
Tám vấn đề khi AI tham gia nghiên cứu, mỗi vấn đề có hai giải pháp Kaimei đang áp dụng.
Ở phần trước em có nhắc tới rủi ro khi đưa agent vào lab. Vậy làm sao để lab yên tâm giao dữ liệu cho Kaimei? Đội em đi theo tám rủi ro của khung Responsible AI, và với mỗi rủi ro, Kaimei đặt sẵn hai rào chắn ngay trong hệ thống.
Đầu tiên là con người giám sát: người dùng duyệt từng plan trước khi chạy, bấm Stop là không bước mới nào bắt đầu, và mọi bước, lệnh, kết quả đều được ghi lại để truy vết. Thứ hai là mức tự chủ của AI, cụ thể là chi phí: agent chính dùng model mạnh, việc đơn giản dùng model nhẹ hơn, và chi phí chạy model trên GPU được ghi rõ ngay trong plan để người dùng chủ động.
Thứ ba là ảo giác, tức số liệu bịa: giá trị không có nguồn hoặc sai loài bị trả lại trước khi vào báo cáo, và một review agent độc lập kiểm chéo lại báo cáo. Thứ tư là lạm dụng: mọi phân tử đều được sàng lọc chất độc và chất bị kiểm soát, và agent không tự đặt tổng hợp hay làm thí nghiệm ngoài đời thật.
Bốn rủi ro còn lại xoay quanh dữ liệu. Về quyền riêng tư, mỗi lab có không gian riêng, dữ liệu không lẫn với lab khác, và chỉ đi tới mô hình bên ngoài khi lab cho phép. Về bảo mật, key được mã hóa theo tài khoản, code của agent chạy trong sandbox kín, mạng ra ngoài đi qua proxy và package mới đều được kiểm soát. Về sở hữu trí tuệ, Kaimei không dùng dữ liệu của lab để huấn luyện model, và mỗi nguồn trích dẫn đều được kiểm tra trước khi đưa vào báo cáo. Cuối cùng là thiên kiến: báo cáo của Kaimei nêu rõ giới hạn của dữ liệu, ví dụ một đích ít được nghiên cứu, và mọi phép so sánh của đội đều chốt tiêu chí chấm trước khi chạy.
Giữ đủ tám nhóm rủi ro, mỗi nhóm hai ý bảo vệ ngắn; lời nói giải thích chi tiết để slide dễ quét và dễ hiểu.
Agents & Skills
Whole research tasks, planned with you.

Specialist sub-agents, in parallel
Keep control
Canvas & Nodes
Every experiment, on one canvas.

15+ Biology Models & Chemistry Tools
Boltz-2
OpenFold2
ChEMBL
UniProt
PubChemSourced Report
Trace Every Artifact
20+ Specialist Skills
Sealed Sandbox
Vậy Kaimei trông như thế nào khi dùng thật? Đây là bản MVP của đội em.
Ô lớn bên trái là agent. Nhà khoa học hỏi bằng lời, agent lập plan, chạy rồi tự kiểm lại kết quả. Phía sau là các sub-agent chuyên môn về đích, protein, hóa học và tài liệu chạy song song, và người dùng luôn giữ quyền: bấm Stop bất cứ lúc nào, và mỗi phiên có trần chi phí. Ô bên cạnh là canvas, nơi mỗi bước agent làm hiện thành một node, các node nối với nhau thành một pipeline mà nhà khoa học nhìn là hiểu.
Ở giữa là hơn mười lăm model sinh học và công cụ hóa học có tên tuổi, như AlphaFold, ESMFold, DiffDock hay Boltz-2, tất cả chạy sẵn trên GPU, không cần cài đặt. Hàng dưới là bốn điểm khiến kết quả đáng tin: báo cáo có nguồn, trong đó mỗi con số đều khớp với dữ liệu gốc, Trace để lần ngược từng file kết quả về đúng bước đã tạo ra file đó, hơn hai mươi skill chuyên ngành mà agent làm theo, và sandbox kín, nơi code chạy riêng từng phiên, không thấy key của người dùng.
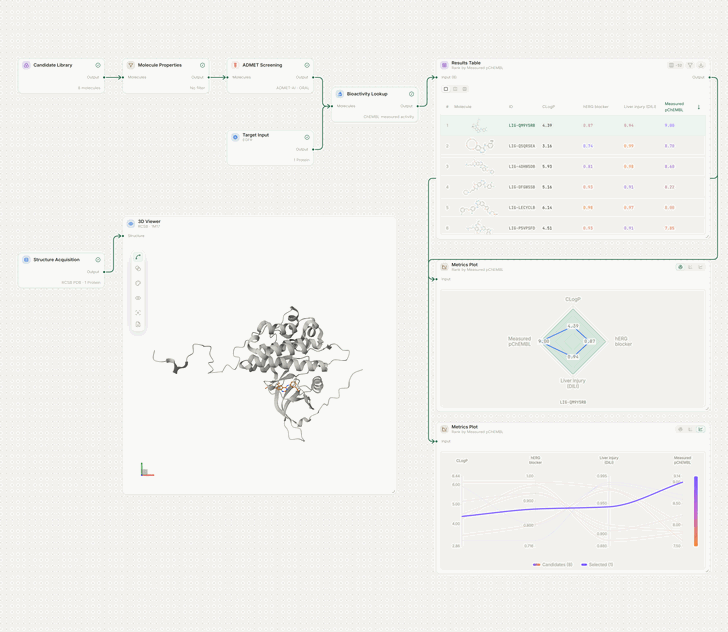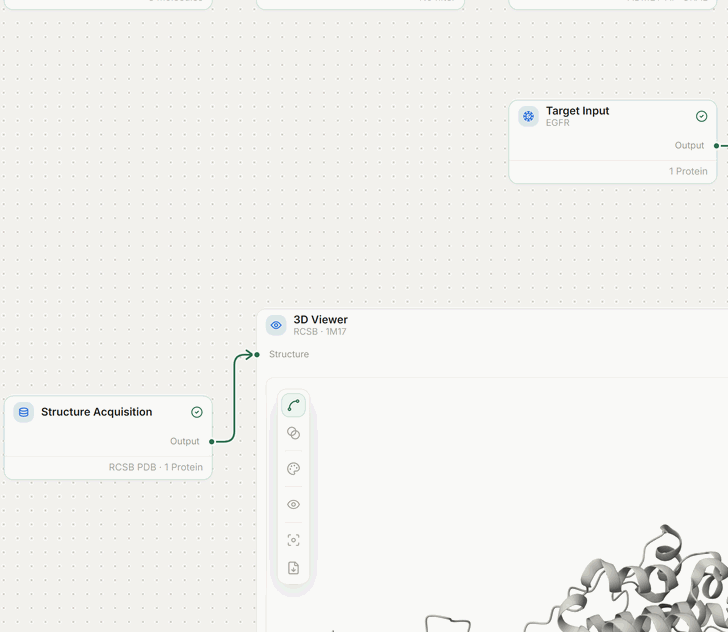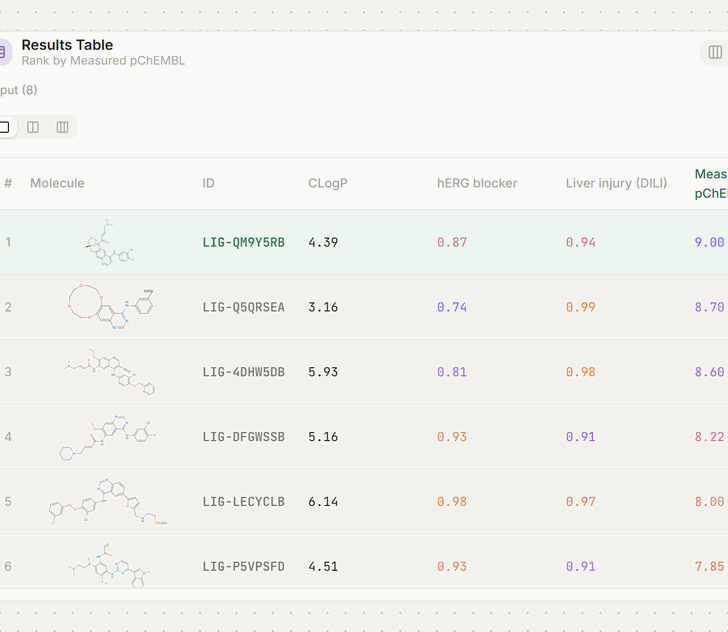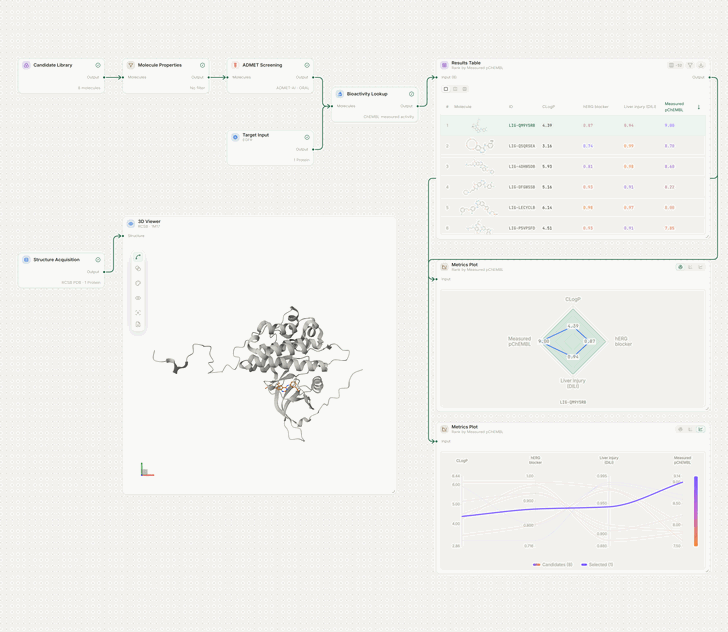
Lấy một ví dụ cụ thể là phiên về EGFR, một protein đích trong ung thư phổi. Đầu ra là bảng ưu tiên phân tử theo hoạt tính đã đo trong ChEMBL, kèm cảnh báo rủi ro tim, gan từ mô hình dự đoán, và báo cáo có nguồn cho từng con số. Từ đó, nhà khoa học chọn được thử nghiệm tiếp theo một cách có căn cứ.
Cho giám khảo thấy sản phẩm đang chạy theo kiểu bento: hai lõi có hình động, các model và tool có tên tuổi, và bốn điểm khác biệt là báo cáo có nguồn, Trace, skill chuyên môn và sandbox kín. Lời nói lấy EGFR làm ví dụ đầu ra, hình chi tiết của ca nằm trong phụ lục hỏi đáp.
Nhà Khoa Học
Giao tiếp trực tiếp với Agent, không cần thành thạo nhiều công cụ hay tự có GPU.
Mục tiêuGiảm thời gian và chi phí mỗi nhiệm vụ
Cách đo: Cùng đề bài với Claude Science: nhanh hơn 2,4 tới 38 lần, rẻ hơn 1,7 tới 6,5 lần.
Lab Và Doanh Nghiệp
Không bước nào chạy khi chưa duyệt, mọi giá trị đều có nguồn, dữ liệu lab không dùng để huấn luyện model.
Mục tiêuGiảm chi phí vận hành, lab nhỏ tiếp cận công bằng hơn
Bằng cách: Pipeline tái sử dụng, phiên chia sẻ giữa các team để hợp tác và khám phá nhanh hơn.
Bệnh Nhân Và Xã Hội
Đích và phân tử có căn cứ hơn, ít thất bại muộn hơn, thuốc an toàn hơn.
Mục tiêu SDGNhà khoa học làm nhanh hơn, lab yên tâm giao dữ liệu, và bệnh nhân có thuốc an toàn hơn. Mỗi giá trị đều đi kèm cách đo cụ thể.
Kaimei giúp nhà khoa học khám phá nhanh hơn, lab nhỏ tiếp cận công bằng hơn, và xa hơn là câu chuyện bệnh nhân có thuốc an toàn hơn.
Vậy Kaimei mang lại giá trị gì, và cho ai? Đội em nhìn theo ba nhóm.
Với nhà khoa học, họ chỉ cần giao tiếp trực tiếp với agent bằng lời, không cần thành thạo nhiều công cụ hay tự có GPU. Mục tiêu là rút ngắn thời gian và chi phí cho mỗi nhiệm vụ: ở hai thử nghiệm cùng đề bài với Claude Science, Kaimei nhanh hơn từ 2,4 tới 38 lần và rẻ hơn từ 1,7 tới 6,5 lần.
Với lab và doanh nghiệp, không bước nào chạy khi chưa được duyệt, mọi giá trị đều có nguồn, và dữ liệu của lab không bao giờ dùng để huấn luyện model. Pipeline dùng lại được và phiên làm việc chia sẻ giữa các nhóm giúp giảm chi phí vận hành, để cả những lab nhỏ cũng tiếp cận được công cụ như lab lớn.
Và xa hơn, với bệnh nhân và xã hội: khi đích và phân tử được chọn có căn cứ ngay từ đầu, sẽ bớt những thất bại muộn, và người bệnh có cơ hội nhận được những loại thuốc an toàn hơn.
Ba giá trị, mỗi giá trị đi kèm cách đo, để giám khảo thấy từng cái kiểm được.
| Tiêu chí | Kaimei AI Agent cho khám phá thuốc | Claude Science Ứng dụng nghiên cứu đa ngành | NVIDIA Clara Nền tảng phát triển AI y sinh |
|---|---|---|---|
| Dành cho | Nhà nghiên cứu thuốc ở lab, biotech và trường đại học | Nhà khoa học đa ngành: vật lý, toán, hóa, sinh, ML | Nhóm phát triển AI, chuyên gia tính toán và R&D |
| 1. Bắt tay vào nghiên cứu | |||
| Cách dùng | Chat và canvas trực quan; agent tự viết code | Chat và code | SDK, code và container |
| Môi trường | Cài sẵn, chạy trên cloud, không cần GPU cá nhân | Agent tự tạo môi trường; máy cá nhân, SSH/HPC hoặc Modal | Hạ tầng GPU của nhóm hoặc dịch vụ API |
| Model sinh học | 15+ model (AlphaFold, Boltz-2, DiffDock…) sẵn trên GPU cloud | Agent tự cài theo phân tích | NIM để nhóm tự triển khai |
| 2. Phối hợp trong nhóm, giữ quyền kiểm soát | |||
| Duyệt & truy vết | Duyệt kế hoạch, dừng việc, truy vết job và tệp kết quả | Duyệt tài nguyên, lịch sử code và reviewer | Tích hợp theo agent và nền tảng triển khai |
| Dùng lại & làm nhóm | Chạy lại, chia sẻ pipeline và kết quả; phân quyền theo tổ chức | Lưu quy trình thành skill; code, tệp đi cùng phiên | Ghép skills thành workflow; quyền truy cập của nhóm |
Clara: nhánh khám phá thuốc.
Nguồn 03/11/2026:Anthropic
Kaimei: hỏi bằng lời, nhận kết quả có nguồn, và trên cùng đề bài nhanh hơn Claude Science 2,4 tới 38 lần.
Kaimei tập trung vào nhóm nghiên cứu thuốc. Điểm đội muốn tối ưu là thời gian từ câu hỏi đến công việc nghiên cứu thực sự: môi trường cho các công cụ tích hợp đã được cài sẵn, nhà khoa học vào ứng dụng, đưa dữ liệu và bắt đầu. Xử lý trên cloud giúp người dùng không phải có GPU cá nhân. Công cụ ngoài phạm vi tích hợp vẫn có thể cần chuẩn bị bổ sung.
Pipeline được lưu để đổi đầu vào và chạy lại. Thành viên có quyền trong cùng tổ chức có thể dùng chung pipeline và kết quả, giúp bàn giao và tiếp tục công việc mà không phải chuyển một môi trường trên máy cá nhân sang máy đồng nghiệp. Đây là chia sẻ tài nguyên theo quyền, không phải tuyên bố cùng sửa canvas theo thời gian thực. Kaimei vẫn có duyệt kế hoạch, Stop và truy vết job, tệp kết quả.
Trong các lần chủ dự án tự thử Claude Science và Phylo.bio, có yêu cầu mất khoảng 60% thời gian để chuẩn bị môi trường, còn khoảng 30-40% cho nhiệm vụ chính. Đây là quan sát ở những lần thử riêng, chưa có bộ nhiệm vụ và phép đo đối chứng, nên không dùng làm số liệu so sánh trên slide. Phylo dùng môi trường cloud và cũng có công cụ, workflow cài sẵn; không suy ra mọi yêu cầu đều phải dựng lại từ đầu.
Claude Science tạo và quản lý môi trường theo phân tích, giữ kernel trong phiên và lưu quy trình thành skill. Bản chủ dự án thử chạy trên máy cá nhân; tài liệu chính thức còn hỗ trợ máy từ xa qua SSH, HPC và Modal, nên mức phụ thuộc phần cứng tùy cách triển khai. Clara là nền tảng phát triển AI y sinh, ở đây so nhánh khám phá thuốc: nhóm kỹ thuật tích hợp model, công cụ và quyền quản lý vào hệ thống của mình. Claude Science cũng tích hợp BioNeMo, nên các nền tảng có phần bổ trợ nhau. Kaimei đang hoàn thiện các bước kiểm tra MVP; số đo cụ thể của hai thử nghiệm chạy trên cả hai nền tảng ở slide tiếp theo.
Làm rõ lợi ích của Kaimei: môi trường cho công cụ tích hợp có sẵn, xử lý trên cloud, dùng lại và chia sẻ pipeline/kết quả theo tổ chức; phân biệt trải nghiệm thử riêng với năng lực được công bố của đối tác.
Thử nghiệm 1Docking lại erlotinib vào PDB 1M17, lấy 10 tư thế
Tiêu chí: Tư thế tốt nhất cách tư thế tinh thể dưới 2 Å
Kết quả: Cả hai đạt (Kaimei 1,16 Å, Claude Science 0,92 Å)
Thời gian tới kết quả
Nhanh hơn38 lần
Chi phí
Rẻ hơn6,5 lần
Thử nghiệm 2Tra cứu đột biến EGFR làm erlotinib mất tác dụng
Tiêu chí: Mọi bài báo trích dẫn phải có thật
Kết quả: Cả hai đạt, không bên nào bịa nguồn
Thời gian tới kết quả
Nhanh hơn2,4 lần
Chi phí
Rẻ hơn1,7 lần
Vì sao nhanh và rẻ hơn
Toolchain và harness sẵn sàng
Không phải setup môi trường cho mỗi yêu cầu; ở thử nghiệm 1, riêng phần này đã chiếm 24 phút ở phía đối chiếu.
Plan biên dịch sẵn, công cụ chạy theo plan
Agent không phải tự gõ lệnh, đọc log rồi thử lại từng bước, nên cần ít lượt gọi model và ít token hơn.
Dữ liệu được chia sẻ trong tổ chức
Dữ liệu và kết quả tra cứu được cache, lưu trữ để các pipeline và phiên làm việc trong cùng tổ chức dùng lại.
Đo ngày 03-04/11/2026 trên app.kaimei.bio và Claude Science; thời gian tính từ lúc gửi đề tới báo cáo, chi phí theo token và bảng giá của từng bên.
Cùng đề bài, cùng model cho agent chính và agent phụ: Kaimei ra kết quả nhanh hơn và rẻ hơn.
Để so sánh bằng số đo thật, đội em chạy cùng một đề bài trên Kaimei và Claude Science: agent chính của hai bên cùng là Claude Opus 5 ở mức suy nghĩ High, agent phụ cùng là Claude Sonnet 5.5; riêng agent review, Kaimei dùng GPT-6 Astra còn Claude Science dùng Claude Opus 5.5.
Thử nghiệm 1 là docking lại erlotinib vào cấu trúc 1M17 và đo tư thế tốt nhất cách tư thế tinh thể bao nhiêu. Kaimei xong trong 55 giây với khoảng 0,54 USD; phía đối chiếu mất 34 phút 33 giây và khoảng 3,5 USD, trong đó riêng 24 phút đầu là setup môi trường. Chất lượng tư thế của hai bên đều đạt, dưới 2 angstrom.
Thử nghiệm 2 là tra cứu tài liệu: những đột biến EGFR nào làm erlotinib mất tác dụng. Kaimei xong trong 3 phút 14 giây, 1,44 USD; phía đối chiếu 7 phút 48 giây, 2,42 USD; không bên nào bịa nguồn.
Vì sao nhanh và rẻ hơn: toolchain và harness của Kaimei đã sẵn sàng nên không phải setup cho mỗi yêu cầu; plan được biên dịch sẵn và công cụ chạy theo plan, agent không phải thử sai từng lệnh nên dùng ít token hơn; và dữ liệu, kết quả tra cứu được cache, lưu trữ để các pipeline và phiên làm việc trong cùng tổ chức dùng lại. Ở thử nghiệm 2, lượt Kaimei được quay có dùng lại kết quả tra cứu từ các lượt trước; lượt thứ hai của phía đối chiếu cũng dùng lại trí nhớ của lượt đầu và mất 4 phút 06 giây.
Cho giám khảo thấy bằng số đo thật: cùng đề bài, cùng model chính, Kaimei nhanh và rẻ hơn, và lý do nằm ở môi trường sẵn sàng, plan biên dịch sẵn và dùng lại kết quả.
2027 · Đưa sản phẩm tới người dùng trong ngành
Q1 2027
Chuẩn bị cho triển lãm
Hoàn thiện trải nghiệm và demo. Hợp tác với FPT AI Factory để triển khai model sinh học trên NVIDIA GPU.
Mục tiêu: kiểm chứng hiệu năng và chi phí trước Expo.
Q2 2027
Pharma IT & Digital Health Expo
21-23/04/2027 · Tokyo Big Sight
Mục tiêu: demo cho 50 khách hàng tiềm năng trong ngành.
Q3 2027
Pilot cùng phòng lab
Đưa bài toán từ triển lãm vào dùng thử, đo chất lượng và công sức tiết kiệm.
Q4 2027
Hoàn thiện sau pilot
Tiếp tục kiểm chứng trên bài toán thực tế và cải tiến sản phẩm theo phản hồi của phòng lab.
2028 · Hướng tới bản thương mại
Q1-Q4 2028
Mở rộng hợp tác để đưa ra bản thương mại
Hợp tác với biotech, pharma và lab đại học để mở rộng quy trình, kiểm chứng và hoàn thiện sản phẩm.
Khách hàng tiềm năng để tiếp cận
Nhật Bản: Takeda · Chugai Pharmaceutical
Việt Nam: Nanogen · VABIOTECH
Lịch triển lãm: pharmait-expo.com/exhibit
Về lộ trình tiếp theo, trong quý một năm hai không hai bảy, đội em tập trung hoàn thiện trải nghiệm và chuẩn bị những ca demo sát công việc của nhà nghiên cứu. Đội sẽ hợp tác với FPT AI Factory để triển khai các model sinh học trên hạ tầng NVIDIA GPU, với mục tiêu kiểm chứng hiệu năng và chi phí trước triển lãm. Mốc trọng tâm là đầu quý hai: Pharma IT & Digital Health Expo, diễn ra từ ngày hai mươi mốt tới hai mươi ba tháng tư năm hai không hai bảy tại Tokyo Big Sight. Mục tiêu của đội là demo sản phẩm cho năm mươi khách hàng tiềm năng trong cùng lĩnh vực, qua đó hiểu rõ nhu cầu và tìm cơ hội dùng thử.
Sau triển lãm, quý ba đội hướng tới pilot cùng phòng lab để đo giá trị trên bài toán thực tế. Quý bốn tiếp tục kiểm chứng và hoàn thiện sản phẩm từ phản hồi của các lab. Trong cả bốn quý năm hai không hai tám, đội hướng tới mở rộng hợp tác với biotech, pharma và lab đại học để đưa ra bản thương mại. Các doanh nghiệp mục tiêu để tiếp cận có thể kể tới Takeda và Chugai Pharmaceutical ở Nhật Bản, Nanogen và VABIOTECH ở Việt Nam. Đây là lộ trình dự kiến, còn mốc triển lãm và mục tiêu năm mươi khách hàng là trọng tâm gần nhất.
Năm 2027 chia theo bốn quý, Q4 tiếp tục hoàn thiện sau pilot. Năm 2028 gom cả Q1-Q4 thành giai đoạn mở rộng hợp tác để đưa ra bản thương mại. Giữ mốc triển lãm 21-23/04/2027 và mục tiêu demo cho 50 khách hàng tiềm năng.
KaimeiNơi nhà khoa học cùng các tác nhân AI đẩy nhanh hành trình khám phá thuốc.
Cảm ơn quý vị đã lắng nghe. Mời quý vị đặt câu hỏi và góp ý.
kaimei.bio
Cuộc thi AI Việt Nam - Nhật Bản 2026 · Đội OSK LAB
Kaimei là nơi nhà khoa học cùng các tác nhân AI đẩy nhanh hành trình khám phá thuốc. Em xin cảm ơn ban giám khảo và các anh chị đã lắng nghe. Đội OSK LAB rất mong được trao đổi, nhận câu hỏi và góp ý từ mọi người.
Lặp lại câu định vị, rồi để màn hình này đứng suốt bảy phút hỏi đáp.
Vietnam Japan AI Hackathon 2026 · OSK LAB
Appendix
Tài Liệu Tham Khảo Cho Phần Hỏi Đáp
Em có chuẩn bị thêm ba hình để trao đổi kỹ hơn về luồng chạy pipeline, kiến trúc và cách các agent phối hợp. Em xin mở phần phù hợp với câu hỏi của anh chị.
Ngăn rõ phần pitch năm phút với các slide dự phòng phía sau, để không ai tưởng bài trình bày còn tiếp.
Nếu anh chị muốn biết một pipeline chạy thực tế thế nào, đây là luồng cơ bản, lấy phiên EGFR làm ví dụ, chia theo bốn làn: nhà khoa học, hệ thống Kaimei, agent và các dịch vụ, mỗi làn ghi rõ tầng và công nghệ tương ứng.
Nhà khoa học hỏi bằng lời trên web. Hệ thống mở một phiên mới chạy trên Temporal và nạp các skill liên quan nếu có, rồi agent lập plan gồm các bước và ước tính chi phí. Plan chỉ chạy khi nhà khoa học duyệt; nếu chưa ổn, họ yêu cầu thay đổi và agent lập lại plan.
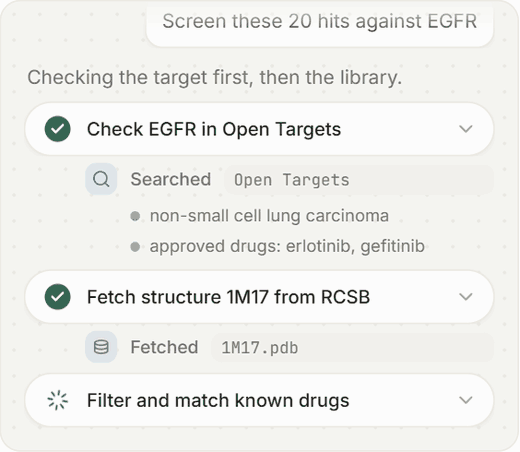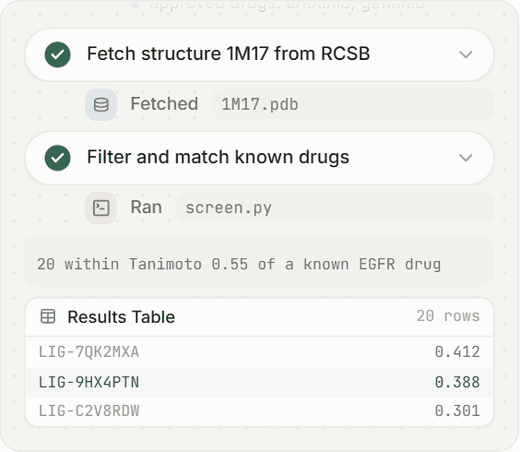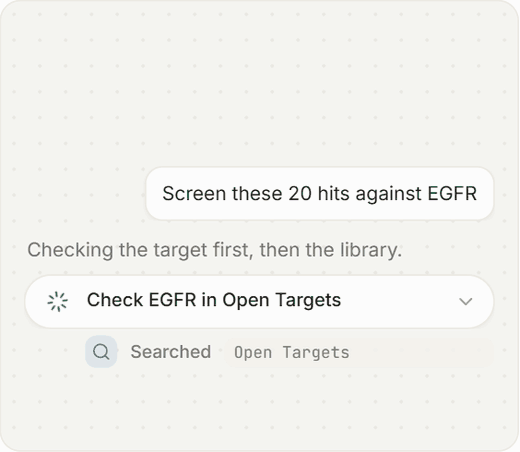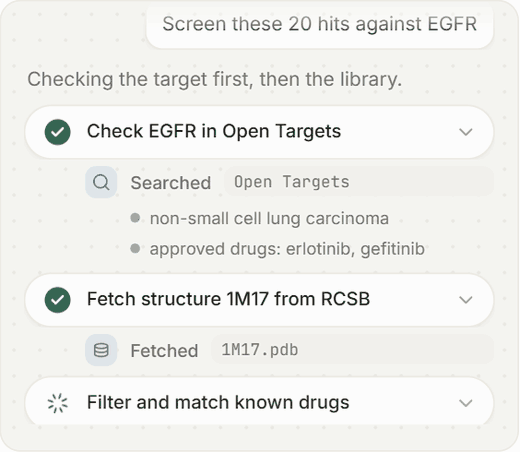
Sau khi duyệt, hệ thống chạy từng bước, mỗi bước hiện thành một node trên canvas, và nhà khoa học xem pipeline cùng các bước thực thi ngay trên canvas. Trần chi phí luôn được giữ, job tốn phí phải chờ duyệt. Các agent chuyên môn về đích, protein, hóa học và tài liệu gọi công cụ thật cho bốn giai đoạn: Open Targets, UniProt và RCSB để chọn đích, ChEMBL và RDKit để sàng lọc, Boltz-2 và DiffDock để docking, ADMET-AI để gắn cờ rủi ro tim và gan.
Cuối cùng agent rà nguồn và viết báo cáo, hệ thống lưu trace, plan và file, để nhà khoa học đọc báo cáo có nguồn, xem lại pipeline trên canvas và sign off kết quả.
Luồng cơ bản khi một pipeline chạy thực tế, vẽ thành sơ đồ swimlane giữa con người, hệ thống và agent, mỗi làn kèm tầng và dịch vụ của nó, để giám khảo thấy ai làm gì, theo thứ tự nào, và chỗ nào con người quyết định.
Web App
Next.js
API
FastAPI
Agent Runtime
LangGraph · Temporal
OrchestratorTargetProteinChemistryLiteratureMemoryKnowledge, contextFile Store
On Amazon EBS
PostgreSQL
On Amazon EBS
Sealed Sandbox
Egress proxy
GPU Models
NVIDIA NIM, Boltz-2
LLM
Anthropic, OpenAI, OpenRouter
Public Data
UniProt, RCSB, ChEMBL
External
One session, step by step
Đây là kiến trúc của Kaimei. Em xin đi theo đúng thứ tự một phiên làm việc, theo bảy bước đánh số trên hình.
Bước một, nhà khoa học đặt câu hỏi, duyệt plan và nhận báo cáo trên web app, nơi có canvas, khung chat với agent và trang kết quả. Bước hai, API nhận yêu cầu và mở một phiên agent. Phiên này chạy bằng LangGraph trong Temporal, với agent điều phối và bốn agent chuyên môn về đích, protein, hóa học và tài liệu, cùng bộ nhớ giữ tri thức và ngữ cảnh.
Bước ba, mỗi skill chạy code trong một sandbox kín, riêng cho từng phiên. Bước bốn, khi cần các model sinh học nặng, hệ thống gọi tới GPU qua NVIDIA NIM và Boltz-2. Bước năm, agent suy luận bằng mô hình ngôn ngữ mà người dùng chọn. Bước sáu, dữ liệu công khai như UniProt, RCSB và ChEMBL chỉ được lấy qua một cổng mạng kiểm soát. Và bước bảy, mọi dấu vết, plan và file kết quả được ghi vào cơ sở dữ liệu và kho lưu trữ, để có thể xem lại từng bước.
Khung AWS bao quanh là hệ thống đang chạy thật trên AWS Tokyo, tại app.kaimei.bio: toàn bộ chạy trên một máy EC2, image lấy từ ECR, HTTPS qua Caddy, quản trị qua Session Manager, không mở cổng SSH, và toàn bộ hạ tầng viết bằng Terraform. Nhà khoa học chỉ làm việc trên web, còn toàn bộ hạ tầng phía dưới do Kaimei vận hành.
Không nằm trong năm phút, chỉ mở khi giám khảo hỏi về kiến trúc. Chia theo tầng web, API, agent, dữ liệu và compute, có bảy luồng đánh số theo thứ tự một phiên, và khung AWS là bản đang chạy thật tại app.kaimei.bio.
Hình này mở rộng slide Agentic AI, để anh chị thấy rõ từng vai trò trong một phiên. Các số từ một tới năm trên hình là thứ tự công việc: mục tiêu, ngữ cảnh và dữ liệu, quyết định, hành động và kết quả.
Mọi thứ bắt đầu từ nhà khoa học, người đặt câu hỏi và ngân sách. Agent điều phối nhận mục tiêu đó, đọc ngữ cảnh và tri thức từ bộ nhớ, chọn skill phù hợp trong kho hơn hai mươi skill, rồi lập kế hoạch. Khi kế hoạch được duyệt, agent điều phối giao việc cho bốn agent chuyên môn: agent đích tìm và xếp hạng đích, agent protein dự đoán và thiết kế cấu trúc, agent hóa học docking và chấm điểm phân tử, agent tài liệu đọc và trích dẫn bài báo.
Các agent chuyên môn gọi công cụ sinh học, hóa học và chạy code, và các bước đó hiện thành pipeline trên canvas. Vòng lặp của agent chạy tới khi xong việc, vì kết quả của bước trước có thể đổi bước sau, ví dụ thiếu dữ liệu về protein thì cần tìm thêm tài liệu trước khi phân tích phân tử. Kết quả phải qua cổng rà soát, kiểm nguồn và ngữ cảnh, rồi mới thành báo cáo có lập luận. Ở những điểm đánh dấu trên hình, nhà khoa học là người quyết định, và trước mỗi lượt chạy đều có bước kiểm an toàn.
Không nằm trong năm phút, chỉ mở khi giám khảo hỏi đội agent làm việc thế nào. Dùng đúng hình Agentic AI của proposal đã nộp, nên lời trên slide và proposal không lệch nhau.